一段简介在编辑器里读起来完全正常,段落清楚,内容也没问题。可它一旦进入公开页面,服务器却返回错误。这时候,最容易想到的处理是删掉换行,或者把校验关掉。
我最近参与处理的一次内容发布故障,让我改变了这个顺序:先不要改稿,先问同一段文字被送到了哪里。 给读者看的正文、网页摘要和结构化数据里的描述,可能来自同一份内容,却不一定接受同一种输入形式。
这篇只讨论一个具体问题:当多段简介遇上应用自己的单行元数据限制,怎样修复而不破坏原文。它不是“所有换行都会弄坏 SEO”的通用结论。
预览通过,为什么不能证明公开页面也能渲染
这次故障的事实链很短:一份已经审核的内容带有多段简介;预览能显示;公开渲染时,简介原样进入结构化数据构造环节,被应用的字段校验拒绝,最终导致页面报错。
关键差异不是文章突然变坏了,而是预览没有经过同一条公开元数据处理路径。后续恢复记录表明,发布后的检查发现异常并触发了回退,但这没有免掉已经发生的一次失败。
这里需要克制归因。仅凭“预览好、上线坏”,还不能认定都是元数据问题。它也可能来自别的环境或内容差异。本例之所以能定位到这里,是因为失败字段、实际输入、拒绝条件和修复后的验证能互相对应,而不是靠猜测。
对读者可复用的排查起点,是把内容流向拆开:正文如何显示?摘要如何生成?结构化数据怎样构造?哪一步首次拒绝了这段输入?不要只盯着最终的 HTTP 错误码。
先分清:标准的限制,还是应用的限制
Schema.org 把 description 定义为对象的描述,预期值类型包括 Text 和 TextObject;这个属性页面并没有规定“作者写简介时只能写一行”。[1]
JSON 也不是完全不能表达换行。RFC 8259 第 7 节要求字符串中的控制字符进行转义;这与“字符串的内容不能包含换行”是两回事。用正确的序列化器表达换行,和把一个未经转义的真实换行硬拼进 JSON 字面量,不能混为一谈。[2]
所以,这次应当得出的结论是:这个应用对某些元数据采用了更窄的输入约束,而调用方没有做好转换。 不能把应用约束上升成 Schema.org 的通用规则,也不能把所有类似现象归咎于搜索引擎。
Google 对结构化数据的说明强调,它描述的是所在页面的内容。[3] 因而,修复也不能走向另一个极端:为了让字段“合法”,把真实简介替换成一段与正文无关、看起来像 SEO 文案的空话。
一份独立小实验,把两种错误分开
为避免依赖具体站点,我另外构造了一段只有两句的测试文本:
第一段说明问题。
第二段说明边界。
实验只做几件事:先用 JSON 序列化再解析,检查能否还原原文;再用一个明确拒绝换行的单行字段校验器检查原文;最后,只对副本做空白归一化,然后重新校验,同时比较原文是否仍然保持不变。
实际运行结果是:JSON 往返还原成功;原始多段文本被模拟的单行合同拒绝;转换后的副本通过;原文仍保留段落。对普通摘要、回车换行、制表符,以及带引号和反斜杠的文本也做了补充检查。
这个实验没有证明某个框架普遍存在缺陷,也不是可直接用于生产的安全过滤器。它只把一个容易混淆的问题分离出来:序列化能否表达数据,与业务字段是否接受数据,是两道不同的检查。
修在输出边界,不要为了摘要把原文改坏
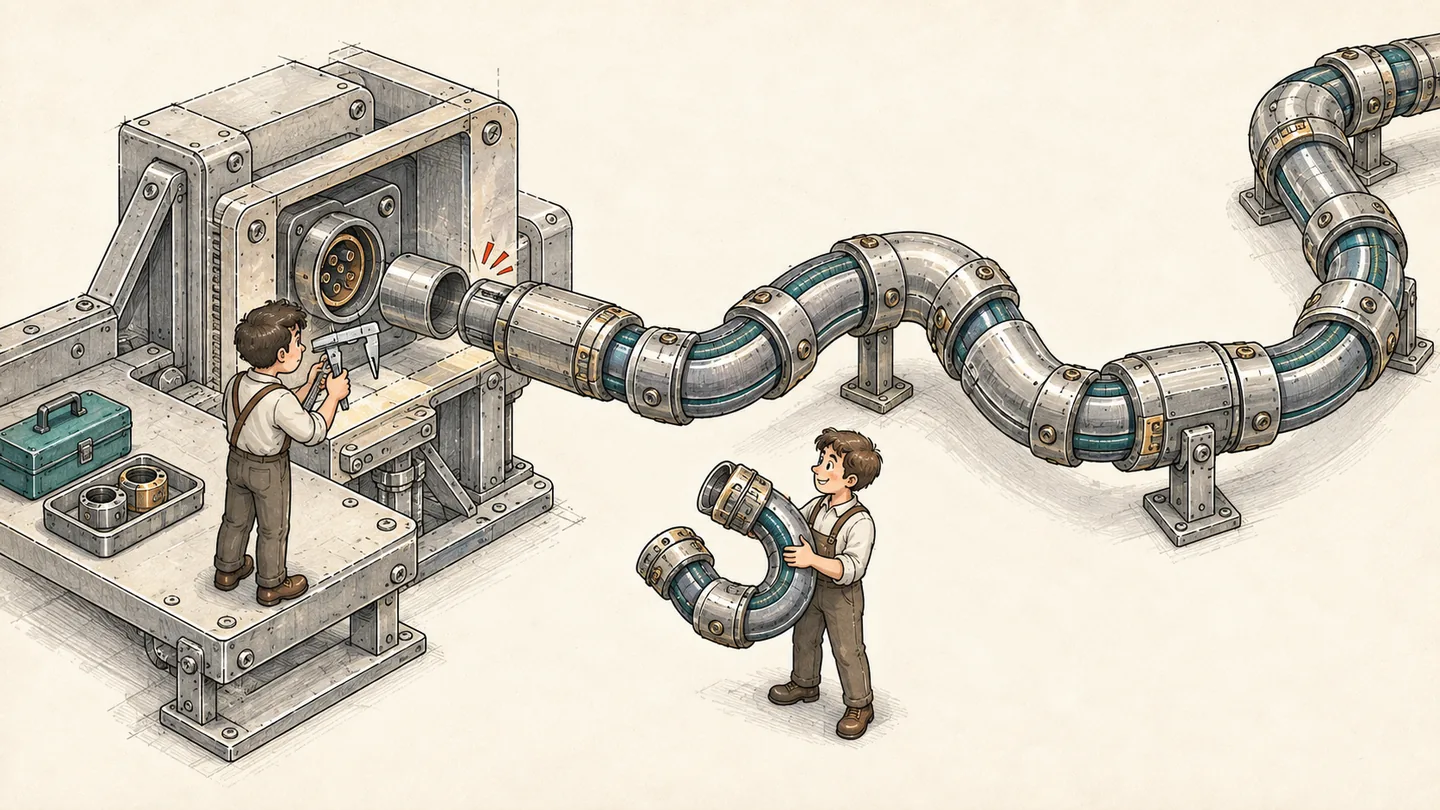
我更认可的修正位置,是从内容生成元数据的那一步:原始简介保留,给读者看的段落保留;如果目标字段确实要求单行,就在那里生成一份符合该要求的副本。
这样做有三个好处。
第一,内容不替程序承担格式债。 编辑者不需要记住某个隐藏字段怕换行,也不必为了通过页面生成而把正常段落揉成一团。
第二,不同用途可以分别处理。 页面标题、搜索摘要、分享描述、结构化数据描述,不必机械共用同一个长度限制。需要限制时,应当明确它来自哪个组件或产品约定,而不是随手写一个数字再叫作“SEO 标准”。
第三,转换可以独立验证。 修复前的样本应能触发原来的错误;修复后的输出要通过目标合同;源内容不能被改写。对已经转换过的值再转换一次,结果也应稳定。
但空白整理不能代替全部安全处理。它不负责判断 HTML 是否安全,不负责消除所有不可见字符,也不替代面向 JSON 或 HTML 输出场景的编码。这里的原则不是“删掉一切不认识的字符”,而是每一层只处理自己明确负责的问题;不合法且无法解释的数据仍应被挡在发布前。
别用“没抛异常”代替发布验收
修复一个字段还不够。这次复盘更重要的改变,是把检查放到真正写入公开状态之前,并让它尽量接近将要发布的组合:同一份候选内容、将要运行的应用版本、公开渲染模式。
如果检查用的是另一份演示内容,或者仍走省略元数据的预览路径,就可能再次得到一个没有回答问题的“通过”。
对于同类问题,我会把验收压成下面几项,而不是扩成无边界的全站重审:
- 用触发过故障的内容检查公开页面,不只检查首页。
- 确认正文仍可见、段落没有因修复而丢失。
- 读取实际返回的标题、描述和 JSON-LD,既看能否解析,也看含义是否仍对应页面内容。
- 如果站点地图等输出也共用这个元数据函数,一并检查受影响路径;没有共享关系,就不凭空扩大范围。
- 发布后再回读精确页面与发布状态。回退发生过,就把回退后的状态查清楚,不把“重试了一次”当作恢复成功。
这套方法的边界也很明确:它降低的是某类内容形状触发渲染故障的风险,不是对收录、排名或流量的承诺。
最后:一份内容,可以有多种表示
这件事让我更警惕一种省事写法:数据库里已有一个字符串,于是正文、摘要和所有元数据都直接使用它。平时内容简单时,看不出区别;等到真实写作带来段落、引号或更长的表达,隐藏的限制才露出来。
我的结论不是给编辑器加一句“请勿换行”,也不是遇到校验就关闭。内容保留自己的完整表达,输出层承担明确的适配责任,再用实际发布路径验证结果。 该改的是两者之间的连接,不一定是文章本身。
本文由真实故障复盘与独立最小实验整理,AI 辅助核对和编辑。案例已匿名化,不披露项目身份、私有实现与运行配置;实验是单独构造的教学样例,并非生产源码。以下一手来源于 2026 年 9 月 20 日核验;RFC 8259 为 2017 年 12 月发布的标准,其余为持续更新文档。
一手来源与适用范围
[1] https://schema.org/description
[2] https://www.rfc-editor.org/rfc/rfc8259
[3] https://developers.google.com/search/docs/appearance/structured-data/intro-structured-data