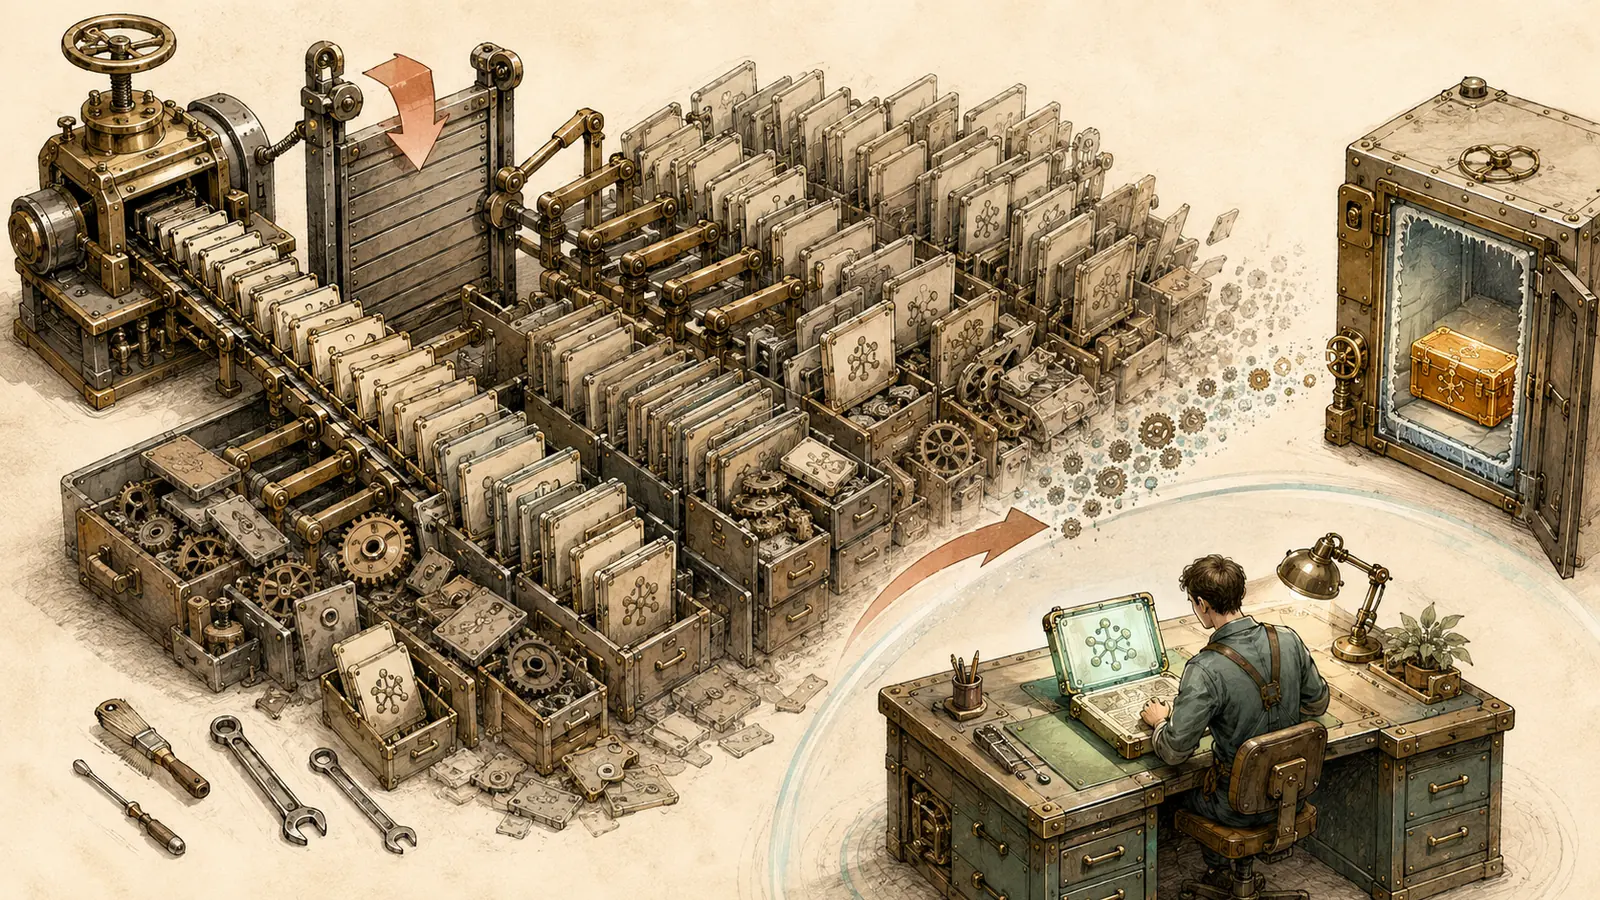
一次自动化任务失败,最容易触发三种本能反应:立刻再跑、重启服务、切换供应商。它们看起来都很积极,却可能把一个短时波动扩大成重复写入、重试风暴或新的配置故障。
我最近遇到过一个很典型的现场:一项定时任务收到明确的云端过载响应,本轮没有形成持久结果;下一次在同一条已锁定路线上执行,却正常完成。期间没有重启本地服务,没有更换认证或供应商,也没有为一次失败新增永久重试机制。
这件事让我再次确认:一次请求失败,只能证明这一次请求没有成功;它不能自动证明本地服务坏了,更不能证明架构需要修改。
先分清四种“失败”
自动化报告里的一个红色状态,可能对应四个完全不同的对象:
- 请求失败:一次远程调用超时、限流或遇到临时过载;
- 任务失败:完整任务没有达到写入、发布或验收终点;
- 服务故障:同一服务持续无法处理健康请求;
- 本地机制故障:认证、网络、配置、状态机或代码在本地稳定复现错误。
它们可以相互关联,但不能靠一次日志直接画等号。我的这次现场只证明前两项:远程请求失败,导致本轮任务未完成。后续同路成功,是反对“本地机制已经损坏”的重要证据。
503 的语义本来就是“现在不可用”
HTTP 语义标准把 503 Service Unavailable 定义为:服务器当前因临时过载或计划维护而无法处理请求,经过一段延迟后很可能恢复;服务端还可以用 Retry-After 建议客户端等待多久。[1]
这并不表示所有“过载”都一定是 HTTP 503,也不保证稍后重试必然成功。它提供的是一种重要边界:临时不可用是一种被协议明确承认的状态,不等于永久故障。
因此,看到这类信号时,合理动作通常是保留现场、等待合适窗口并做有界验证,而不是先重启所有相关组件。
为什么“立即多重重试”可能更糟
Google Cloud 的重试指南把安全重试归结为两个条件:响应是否属于短时错误,以及操作是否具备幂等性。文档将 408、429、5xx、套接字超时和 TCP 断开列为通常值得重试的短时问题,同时提醒认证或配置错误需要先修正,盲目重试没有意义。[2]
更关键的是幂等性:同一个操作执行多次,最终状态是否与执行一次相同。读取列表通常安全;创建订单、发布文章、发消息、扣款或新建资源则可能产生重复副作用。
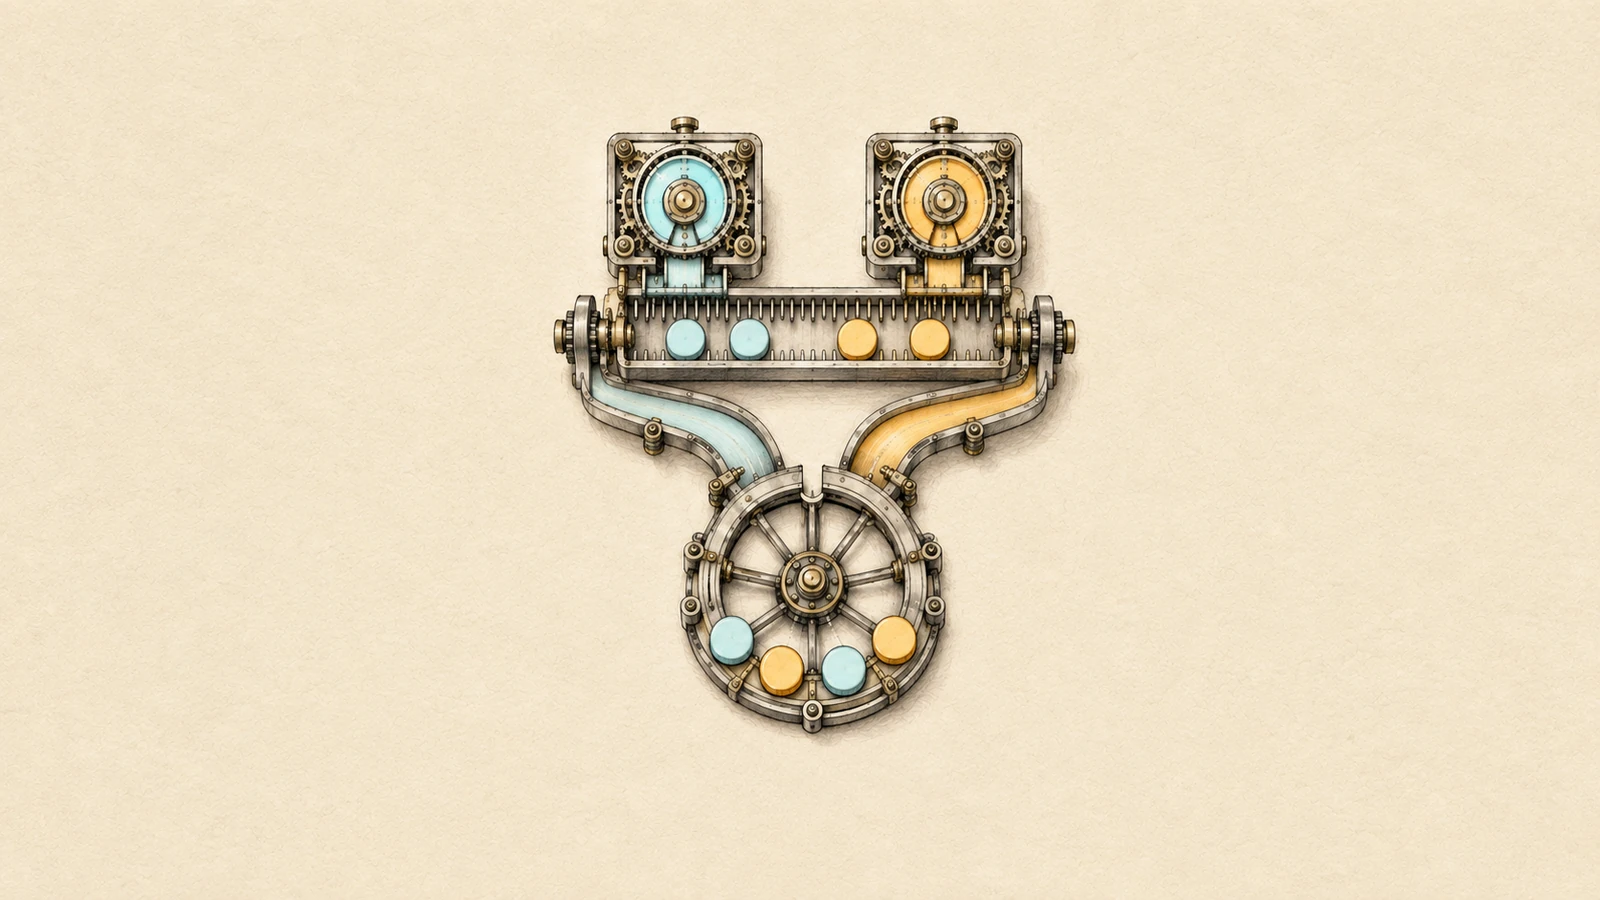
还有一个经常被忽略的问题:底层 SDK 可能已经重试,外层任务又重试,调度器发现失败后再重试。Google 的文档专门提醒,分层重试会把次数相乘;外层三次、内层三次,并不一定是六次,而可能变成九次请求。[2]
如果服务本来就在过载,所有客户端同时立即重试,只会继续推高压力。正确做法是指数退避(等待时间逐步增加)并加入抖动(加入少量随机差异),同时设置总时限和最大次数。[2]
我现在采用的五步判断法
第一步:冻结这一次的事实
只记录可直接证明的内容:哪个动作失败、错误类别是什么、是否已经写入任何外部状态、失败前后的时间和对象是否一致。不要先写“服务挂了”“网络坏了”或“密钥失效”这样的根因结论。
第二步:检查副作用与幂等性
重试前先读目标状态:
- 文章是否已经创建,只是响应丢失;
- 消息是否已发送,但确认超时;
- 资源是否已经生成,只是本地没有收到结果;
- 任务是否有唯一键、请求令牌或精确读回能力。
如果不能证明“重复执行不会重复写”,就不能把自动重试当成默认动作。
第三步:判断错误能否靠本地修改解决
认证拒绝、参数错误、权限不足和配置缺失,需要修正输入或权限;临时过载、429 和部分 5xx 更适合等待后重试。两类错误的处理方向相反:前者重试浪费请求,后者改配置可能制造漂移。
第四步:沿同一路线做一次有界复核
如果操作安全、错误可重试,我倾向先保持账号、服务和配置不变,在退避窗口后执行一次有界复核。这样才能回答“原路线是否已经恢复”。如果一失败就切换供应商,后续成功也无法区分是自然恢复、切换生效,还是另一个系统碰巧可用。
第五步:以持久结果而不是退出码收口
命令返回零、接口返回成功,都只是过程证据。发布任务要读回公开对象,备份任务要验证文件与校验值,消息任务要读回目标会话,数据任务要核对唯一键和最终状态。只有目标状态正确,才能把重试后的任务标为完成。
什么时候应该升级为持续故障
我不会用固定的一次或两次失败机械判定故障,但会看五类证据是否同时增强:
- 同一对象、同一路线在合理时间窗内重复失败;
- 健康探针和正常业务请求也失败;
- 错误从短时过载变成认证、配置或本地状态异常;
- 失败持续跨越服务端给出的等待窗口;
- 多个独立任务出现同一根因特征,而不是共享一条错误摘要。
证据达到这个层级后,才值得进入专项归因,评估重启、切换、限流、熔断或永久重试策略。重启尤其应该最后决定:它会清掉部分现场,还可能把当前可工作的联系链或其他任务一起中断。
一个适合定时任务的最小策略
- 给每次任务一个唯一执行标识,但不要用它替代业务唯一键;
- 对可重试错误设置小次数、指数退避、抖动和总时限;
- 只自动重试已证明幂等或带前置条件的操作;
- 重试前后都读目标状态,防止响应丢失造成重复写;
- 把“本次失败”与“服务持续故障”分开告警;
- 同一路线恢复后,先结束事件,不急着永久增加机制。
适用边界
支付、删除、公开发布、账号认证、数据库迁移和其他高后果操作,即使接口宣称幂等,也要核对具体请求令牌、事务边界与最终读回;不能照搬普通查询的重试策略。相反,对于纯读取、状态查询和可重建计算,短时自动重试可以更积极。
一次失败最有价值的作用,是告诉我们“这里出现了一个需要分类的信号”,而不是替我们宣布根因。先区分错误类型,再检查幂等性;先用同一路线有界复核,再决定是否改系统。这样做看似慢了一步,实际避免了重启、切换和重复写入带来的第二场事故。
本文来自一次真实定时任务短时过载与自然恢复复盘,使用 AI 辅助结构化与校对;供应商、账号、任务内容、时间、调用量和内部运行入口均已移除。
来源与核验
- RFC 9110:HTTP Semantics,503 与 Retry-After(核验于 2026-09-03)
- Google Cloud 官方文档:Retry strategy(核验于 2026-09-03;页面标注更新于 2026-08-26 UTC)