一台大型本地模型真正跑起来以后,我最先产生的冲动不是“它能做什么”,而是“还有什么任务可以塞给它”。后来我发现,这个问题本身就错了。
模型能在本地运行,不等于它适合进入每一条工作流;硬件已经买了,也不等于每个任务都必须经过它。真正应该问的是:哪一种任务形状,能让它产生比等待、校验和维护成本更大的增量?
这是我最近一轮本地大模型实践里,最重要的认识变化。
“能跑”与“适合做实时总顾问”是两回事
我使用的是大型开放权重推理模型这一类方案。以 gpt-oss-120b 为例,OpenAI 的公开资料说明它采用混合专家架构,并称该模型可在单张 80GB GPU 上高效运行。[1]
这类信息证明了本地部署的可行性,却不能替我回答另一个问题:它是否适合在每次对话、每次检索、每个项目判断之前都同步出现。
我做了两类真实测试。
第一类任务很窄:输入少量材料,只要求完成一个目标,例如判断两份官方说明的差异、识别新旧事实的替代关系、把一次故障经验迁移到相似问题,或者在证据无关时明确拒答。这些任务通常能得到结构清楚、方向正确的结果。
第二类任务则把多种证据、多个目标和完整建议塞进一次请求,希望模型像总顾问一样同时理解、比较、归纳、决策并严格输出。结果明显变差:有时等待过长,有时虽然写了很多,却没有满足结构合同;重试也未必恢复。
这并不说明模型“没用”。它说明我把异步语义加工机器错放进了实时总控链路。
我曾经走过的三个错误方向
1. 因为模型大,就默认它应该处理更大的包
参数规模和上下文长度很容易让人产生一种错觉:既然装得下,就应该一次塞得更多。
实际上,输入变大时增加的不只是文字。目标之间会互相竞争,证据可能存在时间、来源和对象冲突,输出还要同时满足格式、权限与结论边界。模型需要处理的是一个耦合系统,而不是一篇更长的文章。
2. 把本地免费推理理解成“多等一会也没关系”
本地调用不按次付费,并不代表等待没有成本。同步链路里的一次长等待,会占住主任务、拖慢反馈,也会让失败后的重试变得昂贵。
如果最后还需要云端主模型重新核对全部证据,那么这段等待甚至没有减少工作,只是增加了一道工序。
3. 让概率模型做规则已经能精确完成的事
去重、日期比较、字段校验、枚举检查、哈希、状态机和权限门,本来就应该由代码完成。让大模型接管这些工作,不会更聪明,只会把确定性问题重新变成概率问题。
重新安排后的三个岗位
岗位一:语义差异检查员
它适合比较少量、同类、边界清楚的材料,例如:
- 两版官方文档到底新增、删除或改写了什么;
- 两条相似故障记录是否属于同一机制;
- 一条新证据是否真正推翻旧结论;
- 某份材料是否足以回答当前问题。
这里的关键不是“让模型总结”,而是给它一个可判定的目标,并要求保留来源和不确定性。
岗位二:候选关系整理员
知识系统最难处理的往往不是保存,而是关系:重复、冲突、替代、继承和适用范围。
大型本地模型可以异步生成这些关系候选,再由规则和主模型审核。它不直接写真相,也不自动删除旧证据,只负责把人工很难批量发现的语义关系提出来。
岗位三:有边界的批处理工人
它还适合夜间或后台处理许多彼此独立的小工单,例如逐条归类经验、检查短文档差异、生成反方观点、识别材料缺口。
我现在更愿意把一个“大而全”的请求拆成多个小工单:每个工单只含少量证据、一个目标、一个输出结构,并有独立超时和校验。失败只影响当前工单,不会阻塞整条主线。
哪些位置我不再让它承担
经过这轮实践,我把以下位置明确留给其他 owner:
- 实时检索与事实定位:优先走快速索引和原始来源,不等待大型模型;
- 精确规则与状态判断:交给代码、Schema 和测试;
- 高风险最终结论:由主模型结合实时证据复核;
- 公开发布、权限、资金和不可逆动作:始终保留明确授权与机械门;
- 证据不足的问题:允许直接返回不知道,而不是逼模型补齐故事。
这套分工的本质不是贬低本地模型,而是让不同能力回到自己擅长的位置。
一个可以直接复用的路由问题
以后遇到新任务,我先问五个问题:
- 结果是否必须立刻返回?
- 输入能否缩成少量同类证据?
- 目标能否只保留一个?
- 输出是否可以机械校验?
- 失败能否只重跑这一小份?
如果答案大多是“可以”,它很适合交给本地大模型异步加工;如果答案大多是“不可以”,就不应该为了使用硬件而强行经过它。
适用边界
这是我在当前模型、推理后端和真实任务上的实践结论,不是所有本地模型的统一性能判决。模型版本、量化、上下文长度、并发、提示方式和推理后端都会改变结果。
因此我不会把一次成功演示当成生产能力,也不会把一次失败扩大成“本地大模型不行”。更可靠的做法是固定小型基准、记录失败类型,再按任务形状持续调整岗位。
结语
硬件最大的浪费,不是没有让它一直忙,而是让它参与了不该参与的工作。
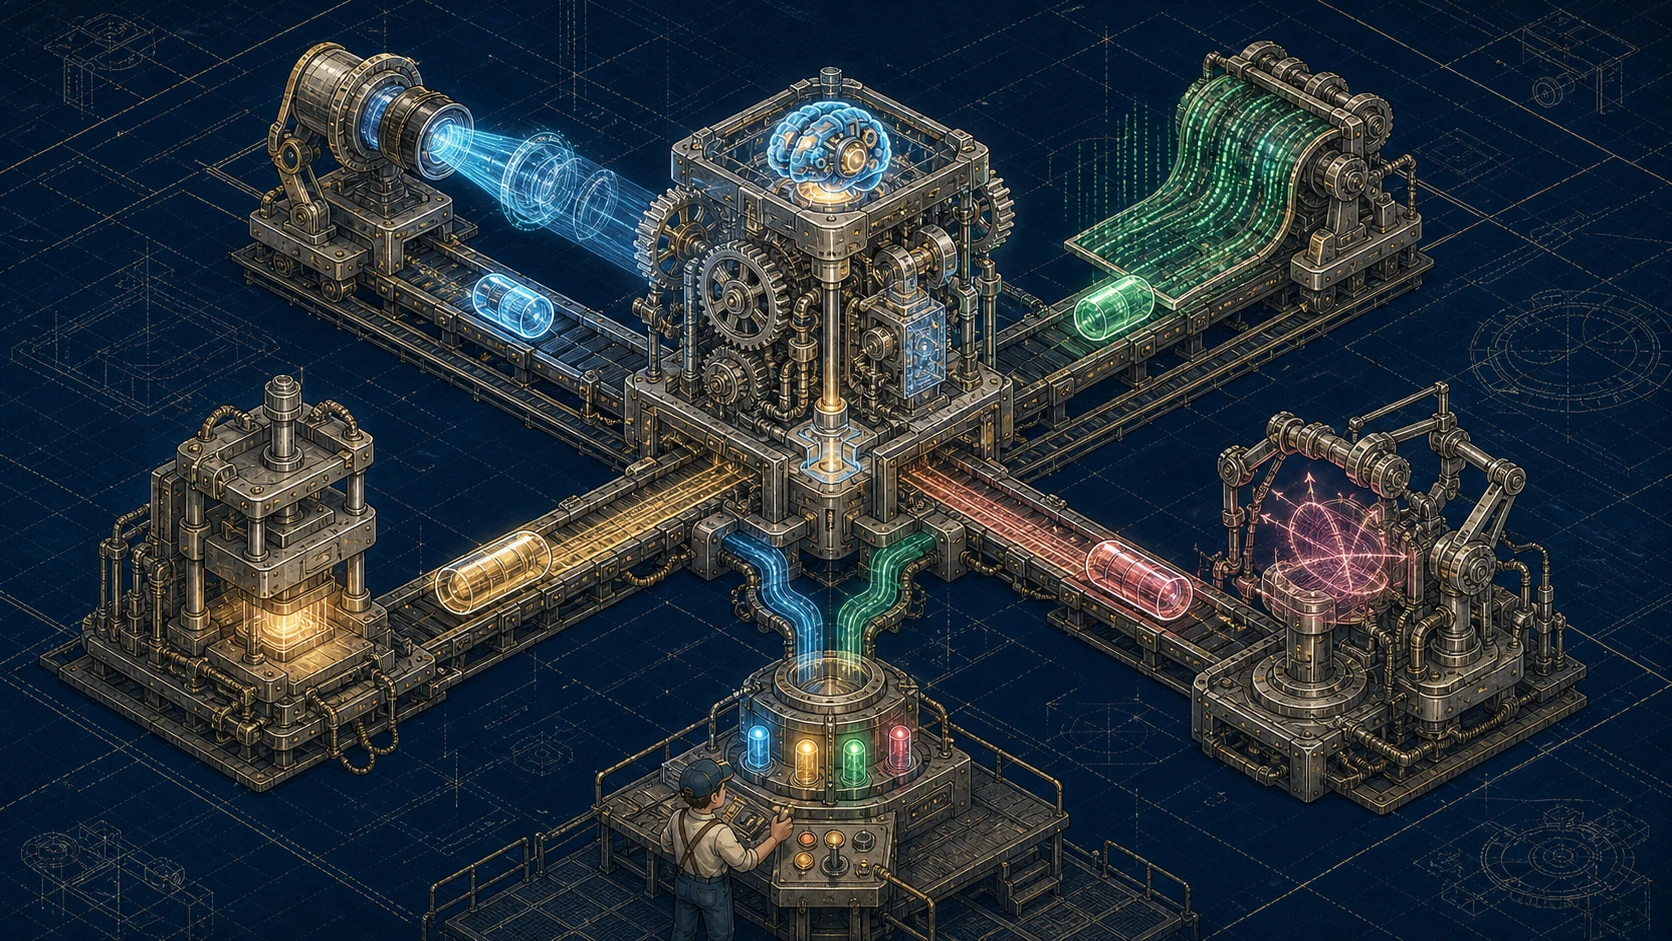
我现在对本地大模型的定位更清楚了:它不是第二个总指挥,而是一座离线认知加工厂。主线需要及时、精确和可恢复;加工厂负责那些不必立刻完成、但值得深入理解的语义工作。
当岗位安排正确以后,本地算力才不是一个需要找理由使用的昂贵摆设,而会变成长期、稳定、可验证的生产能力。
说明:本文由作者依据真实本地模型测试与工作流调整整理,AI 协助结构和文字校对;文中的官方模型信息核验于 2026 年 8 月 28 日,个人测试结论不等同于官方基准。