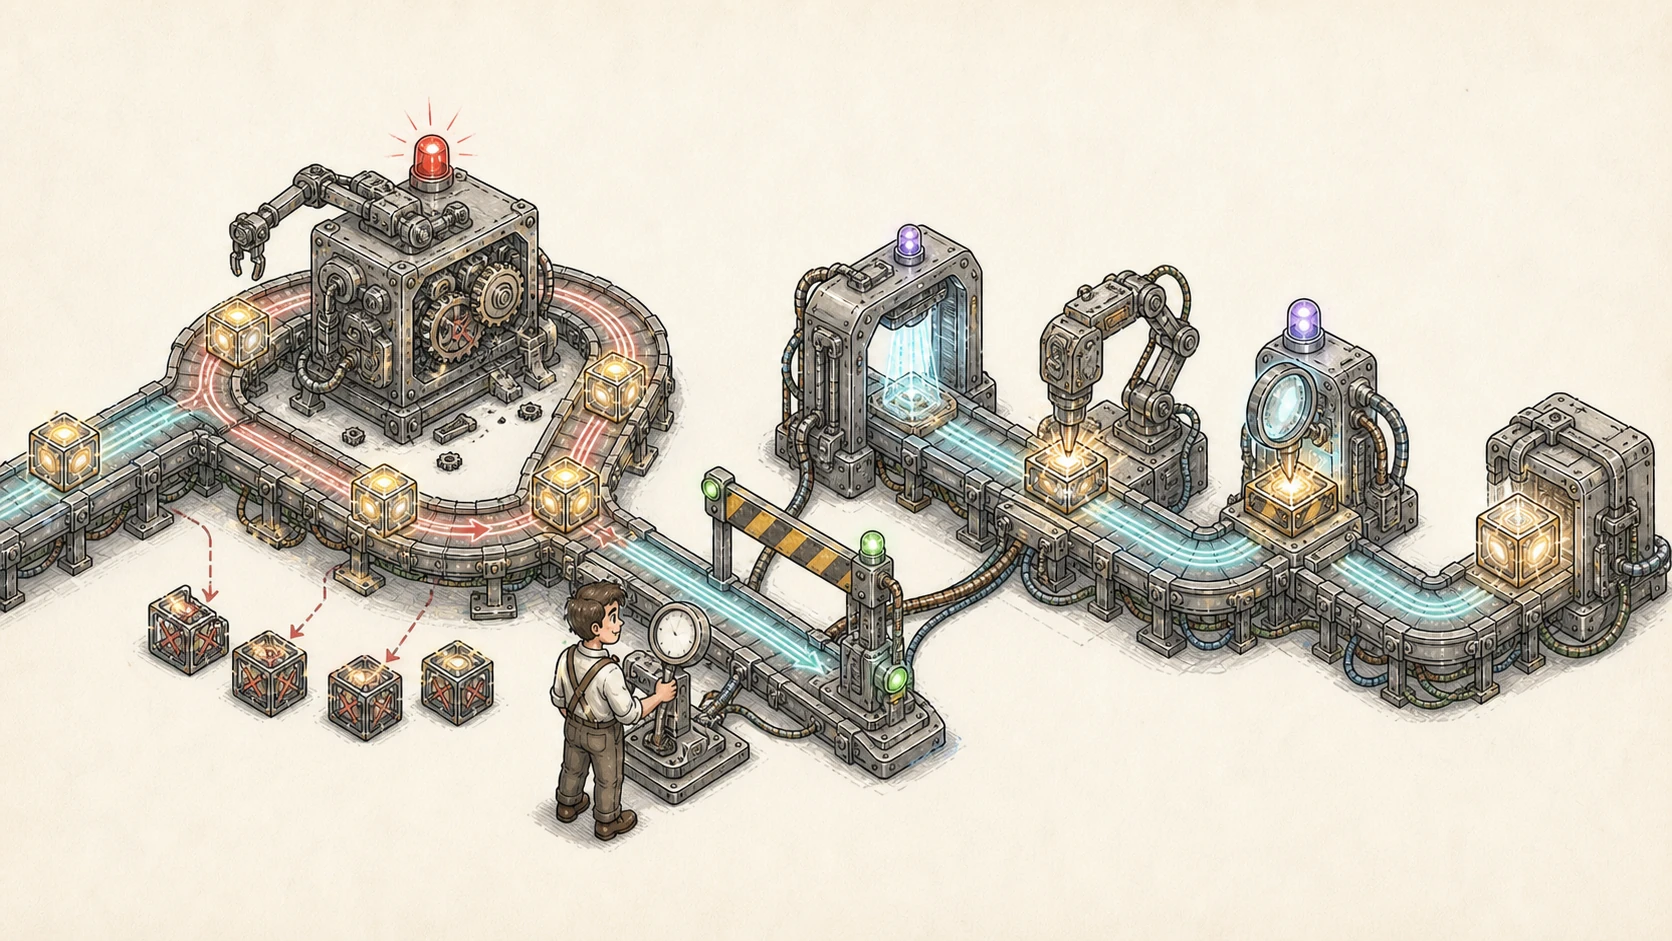
AI Agent 最容易制造的一种错觉,是把“已经开始做”说成“已经做完”。它可能写出了代码、启动了命令、拿到一个 HTTP 200,甚至生成了一张截图,但用户真正需要的功能仍然不可用。
最近连续处理长任务后,我越来越确信:完成不是一句结论,而是一条可以复查的证据链。
证据说明:文中关于 Hermes 功能的描述来自官方文档;关于完成口径和项目分层的判断,是我在长期使用 AI Agent 后形成的个人实践方法。
五种经常被误认为“完成”的状态
- 已经理解需求:只能证明方向大致明确;
- 已经写入文件:只能证明产物存在;
- 命令已经启动:不能证明进程成功结束;
- 接口返回成功:不能证明用户界面可用;
- Agent 宣布完成:本身不构成任何外部证据。
真正的交付通常至少要经过四层:
意图与范围
    ↓
可运行产物
    ↓
真实环境执行
    ↓
用户价值验收
例如网页修改,代码通过语法检查只是第二层;服务加载了新版本是第三层;真实浏览器中内容可见、交互正常、手机没有溢出,才接近第四层。
长会话不是长期真相
Hermes Agent 会保存完整 Session,支持恢复和跨会话检索,但官方文档也明确说明:系统不会在每一轮把所有历史内容重新发送给模型,活动上下文仍然需要选择、压缩和按需检索。[1]
这意味着聊天记录适合保存“发生过什么”,却不适合单独承担“现在是什么状态”。长任务如果只依赖聊天上下文,很容易出现:
- 旧结论在环境变化后仍被当成当前事实;
- 一个局部完成被误认为整个项目完成;
- 压缩后保留了计划,却遗漏关键验收条件;
- 多轮操作后,用户和 Agent 对“正在做哪一步”理解不同。
我的做法:把信息放到正确层
Hermes 官方对 SOUL、USER、MEMORY 和项目上下文文件进行了明确分工。[3] 在真实项目里,我进一步把内容分成以下几层:
| 信息 | 合适位置 |
|---|---|
| 用户长期偏好 | 用户画像或长期记忆 |
| 可复用的操作方法 | Skill 或运行手册 |
| 项目当前版本、入口和状态 | 项目当前真相文件 |
| 代码是否正确 | Git、测试与构建结果 |
| 线上是否真的生效 | 运行环境和浏览器读回 |
| 历史细节与故障过程 | 会话、日志和审计证据 |
同一个事实最好只有一个当前所有者。否则文档、聊天、任务列表和线上环境各写一份,时间一长必然互相冲突。
检查点的作用不是代替 Git
长任务还需要可恢复性。Hermes 的 Checkpoint 机制可以在写文件或破坏性命令前创建快照,并通过 /rollback 恢复;官方同时强调该功能默认关闭,需要显式启用。[2]
检查点适合处理同一工作区里的中间失误,Git 则负责可审查的版本历史。二者都不能代替数据库备份、线上回滚和真实运行验证。
怎样定义一个可验证的完成口径
我现在会在动手前先写清楚三个问题:
- 用户最终能看到或使用什么?
- 哪些证据可以证明它真的生效?
- 如果失败,恢复到哪里?
然后按受影响面选择验证,不给每个小改动套上大型发布流程,也不因为改动很小就省略真实消费。
- 脚本:运行一次真实输入并核对输出;
- 接口:校验状态、结构和持久化读回;
- 网页:真实浏览器检查内容、交互、错误和响应式;
- 定时任务:至少验证一次触发、去重和投递;
- 外部系统写入:成功返回后读取目标对象确认。
结语
AI Agent 真正的价值不是比人更快地产生“完成”两个字,而是减少用户兜底:它知道当前目标、能保存进度、失败时可以恢复,并且只在证据闭合后宣布结果。
计划完成、代码完成、部署完成和价值完成是四件不同的事。把它们分清,长任务才不会越做越乱。